ООО «СОТЕК»
ИНН 5260488533
+7 993 435 0226
Нижний Новгород, ул. Гоголя, 45а-13
info@sawtech.ru
Политика обработки персональных данных
Настройка gulp для front-end разработки в PhpStorm
Gulp — это сборщик проектов, который сам по себе ничего кроме организации потоков не умеет. Зато у него есть тьма плагинов, которые умеют все, что надо для front-end. Лично мне надо чтобы мои SCSS собирались в css, а JS минифицировались. Для компиляции css в PhpStorm можно использовать стандартный scss процессор, написанный на ruby, который отлично с этим справляется, но я стал замечать, что при наличии больше 5 scss, каждый из которых по 500-700 строк, в PhpStorm сборка занимает значительные 3-5 секунд, что для меня является долгим. А в одной из статей было сказано, что gulp-sass умеет это делать быстрее. Зерно сомнения посеяно, шило все глубже внедряется в мозг. В общем, на очередном проекте было принято волевое решение попробовать этот ваш Gulp.
Как я уже писал, мне надо не много:
В идеале, надо будет добавить еще сжатие картинок, но я делаю это пока вручную.
Для начале немого поговорим о том, как я организую структуру проекта:
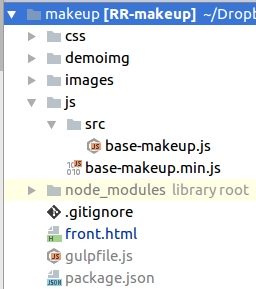
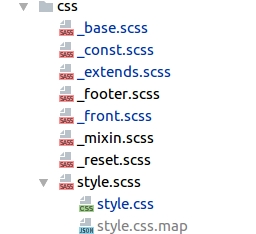
Про стили чуть ниже. Для картинок я создаю 2 папки, те, который имеют отношение непосредственно к дизайну images/, и картинки, которые на этапе прикрутки будут заменены складываем в demoimg/, несжатые скрипты лежат в js/src/, а сжатые в корне js/. Стили мне нравится хранить в одной папке вместе с исходниками, ниже показано как это выглядит.
Не забывайте правильно настроить .gitignore, я надеюсь, что использование Git вошло в привычку, пусть даже кроме вас никто не будет использовать ваши файлы, но git это в первую очередь инструмент контроля версий, а уж потом средство совместной разработки. Мой .gitignore выглядит так:
# Исключим из репозитория папки с картинками
.idea/

# Исключение .map файлов
*.map
*.json

# gulp
gulpfile.js
node_modules
Чтобы работать с Gulp он должен быть у вас установлен, а для этого в свою очередь нужен NodeJS и NPM.
И так, для компиляции SCSS нужен пакет gulp-sass, но этот пакет не умеет генерировать.map, поэтому для его генерации нужен другой пакет gulp-sourcemaps. Для css этого достаточно. Теперь к минификации js. Нужно так же 2 пакета gulp-uglify — сжимает js, а чтобы у файлов появился префикс .min нужен пакет gulp-rename. В архиве пакетов Gulp есть и более эффективные модули, который в одну операцию умеют сжимать и добавлять префикс, но мне не понравилось, что он склеивает все js файлы в один, я хочу чтобы файлы оставались разделены. Для начала из корня проекта инициализируем проект
npm init
Внимательно или не очень следим за всеми пунктами и по необходимости заполняем их. Самое главное главный файл назовите gulpfile.js, установщик об этом спросит. Установка требуемых пакетов совершается одним движением
npm install --save-dev gulp gulp-sass gulp-sourcemaps gulp-uglify gulp-rename
Ключ —save-dev говорит что эти пакеты нужно только для пространства разработки и в продакш идти не должны. В корне проекта появился некий package.json, где указаны все пакеты с которыми мы имеем дело. Нафиг он нужен? Кроме того, что он несет служебную нагрузку, в перспективе я буду его таскать из проекта в проект и установку всех нужный пакетов производить одной командой
npm install
Главное чтобы npm видел этот файл. Он его прочтет и скачает нужные модули.
Собственно, что теперь со всем этим добром делать? Для начала создадим gulpfile.js где напишем слудующее:
'use strict';

var gulp       = require('gulp'),
    sass       = require('gulp-sass'),
    sourcemaps = require('gulp-sourcemaps'),
    uglify     = require('gulp-uglify'),
    rename     = require('gulp-rename');
Это просто подключение нужных пакетов. Можно открыть документацию к кажому пакету и детально изучить возможности. У меня для компиляции css используется такой код:
gulp.task('sass', function () {
	return gulp.src('./css/**/*.scss')

		// Для генераии style.css.map
		.pipe(sourcemaps.init())

		// Собственно компиляция
		.pipe(sass({outputStyle: 'expanded'}).on('error', sass.logError))

		// Куда положить .map
		.pipe(sourcemaps.write('./'))

		// Путь компиляции
		.pipe(gulp.dest('./css'));
});
Для сжатия js
gulp.task('compressed-js', function () {
	gulp.src('js/src/*.js')
		.pipe(uglify())
		.pipe(rename({suffix: '.min'}))
		.pipe(gulp.dest('js'));
});
Задания можно запускать из консоли, но использую PhpStorm как-то это странно. Правой клавишей по gelpfile.js и выбираем пункт Show Gulp Tasks, откроется панель, где показаны доступные задачи
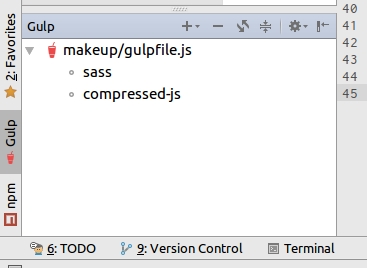
Можно даблкликом запустить любую. Но стоп! С js допустим ладно, периодически ткнуть — ок, но раньше css умел автоматически компилироваться, а теперь как?
Для автоматической компиляции у Gulp есть, так называемые вотчеры (watch). В документации они описаны, они следят за изменением файлов, и при каждом изменении могу запустить ту или иную задачу. Наш код примет следующий вид:
'use strict';

var gulp       = require('gulp'),
    sass       = require('gulp-sass'),
    sourcemaps = require('gulp-sourcemaps'),
    uglify     = require('gulp-uglify'),
    rename     = require('gulp-rename');

// SCSS compiled
gulp.task('sass', function () {
	return gulp.src('./css/**/*.scss')

	// Для генераии style.css.map
		.pipe(sourcemaps.init())

		// Собственно компиляция
		.pipe(sass({outputStyle: 'expanded'}).on('error', sass.logError))

		// Куда положить .map
		.pipe(sourcemaps.write('./'))

		// Путь компиляции
		.pipe(gulp.dest('./css'));
});

gulp.task('sass:watch', function () {
	gulp.watch('./css/**/*.scss', ['sass']);
});


// JS COMPRESSED
gulp.task('compressed-js', function () {
	gulp.src('js/src/*.js')
		.pipe(uglify())
		.pipe(rename({suffix: '.min'}))
		.pipe(gulp.dest('js'));
});

gulp.task('compressed-js:watch', function () {
	gulp.watch('./js/src/*.js', ['compressed-js']);
});
А панель задач Gulp имеет такой вид
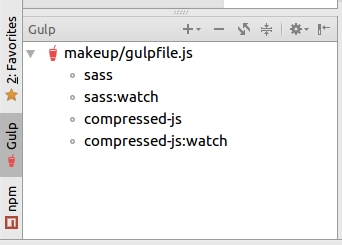
Можно запустить любой вотчер и он будет висеть в процессах, пока его явно не убьешь.
Но я пошел еще дальше и создал общий вотчер, который включает в себя и компиляцию css, и сжатие js, это делается всего одной строкой:
// Смотрим на все
gulp.task('watch', ['sass:watch', 'compressed-js:watch']);
Теперь запускаем один вотчер и при любом изменении js или scss происходят все нужные манипуляции с файлами. Но, на сколько я понял, при добавлении новых файлов вотчер надо перезапускать, по крайней мере у меня он не захотел пережимать js, который был добавлен после запуска.
Конечно, ни что не мешает каждый раз запускать задачу вручную, но IDE предоставляет возможность автоматического запуска задания. Для этого идем в настройки Tool→Startup Tasks
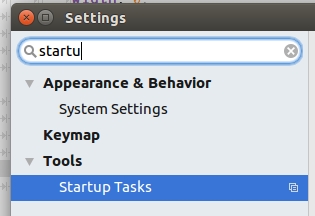
В этом окне слева выбираем добавить новую задачу, и ищем Gulp
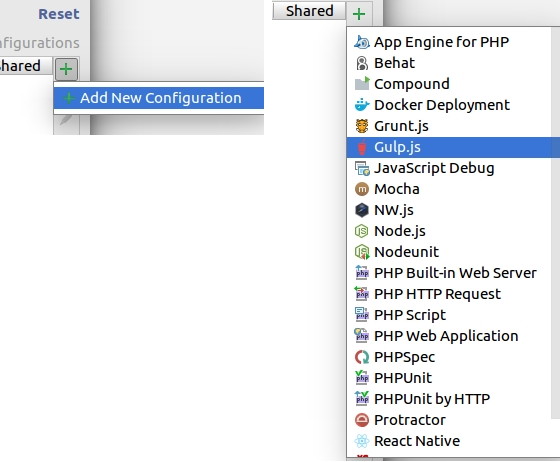
И в открывшемся окне добавляем наши вотчеры, хоть каждый по отдельности, хоть один общий.
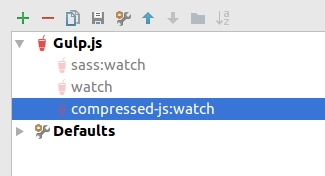
Вот как бы вот так. Главное, если не настроили автоматический запуск вотчеров, не забывать запускать задачу при старте работы над проектом, а то ничего не получится. Но рекомендую переложить на IDE проблему автозапуска. Пока серьезного выигрыша по времени я не увидел, т.к. не было тяжелых проектов, но то, что вижу на небольших файлах, впечатляет. К тому же изучение новых технологи (пусть даже для одного взятого меня она новая), это всегда хорошо для разработчика, чтобы хоть как-то поспевать за изменяющимся миром.
Парсинг сайтов на nodejs
Один пацан писал все на JavaScript, и клиент, и сервер, говорил что нравится, удобно, читабельно. Потом его в дурку забрали, конечно(с)
Мы разработали конструктор для муниципальных образований (МО) московской области и сейчас проводим разворачивание нескольких сайтов. Практически все МО уже имеют сайты, но то как они выглядят, даже на мой сильно испорченный комик сансом взгляд, часто вызывает кровавые слезы и жаление развидеть. Но сайты же есть и там есть какие-то новости, поэтому многие хотят сохранить контент, что логично, никто не хочет работать в пустую. Ну и вот! Задача поставлена, я пошел изучать как это сделать быстро и безболезненно.
Если ты опытный фронтэнд, то JS и JQuery в частности тебе могут быть сильно приятнее, чем php и другие бэкэнд языки. Я честно попытался реализовать парсинг на php, но уж как-то все в итоге получалось громоздко и не технологично, есть определенная доля вероятности, что мне было просто лень все делать «правильно». к тому же снова проснулось желание потыкать в серверный JS. Сказано — сделано. 2 запроса в гугл, 4 поста, полтора мануала и выбор окончательно сделан. JQuery мне знаком как мои 2 шорткода (контрл+Ц, контрл+В. Кстати, как нибудь я покажу фотку моего левого ctrl, такого хорора вы еще не видели =)) А тут еще, оказывается есть отличнейшая библиотека cheerio, которая позволяет с объектами дом дерева обращаться по примеру jquery — красота, да и только!
На момент написания парсинга я еще не познал дзен асинхронности, и писал код так как понимал:
Первая версия имела вид, что-то типа того:
var request = require('request'),
	cheerio = require('cheerio'),
	res_arr = [];

var news_base_url = 'http://need.url?p=';

get_page_content(news_base_url + 0, 0);

function get_page_content( url, i ) {
	request(url, function ( error, response, body ) {

		if( !error ) {
			var $ = cheerio.load(body),
				newses = $('.news-item');

			newses.each(function () {
				var self = $(this),
					cont = self.find('.news-text'),
					itm = {
						title: cont.find('.title').text(),
						date : cont.find('.date').text(),
						link : cont.find('a').attr('href'),
						img  : cont.find('img').attr('src')
					};


				itm.content = get_post_content(link);

				res_arr.push(itm);
			});

		} else {
			console.log("Произошла ошибка: " + error);
		}
	});
}

function get_post_content( link ) {
	request(link, function ( error, response, body ) {

		if( !error ) {
			var $ = cheerio.load(body, {decodeEntities: false});

			return $('.text').html();
		} else {
			console.log("Произошла ошибка: " + error);
		}
	});
}
Ключ на старт. Первый запуск… и я все понял. Это работать не будет. Преимущество nodejs — асинхронность, она же, в моем случае, стала проблемой. Т.е. в тот момент, когда я забираю контент первой новости первой страницы, у меня уже может считаться 3я страница новостей и указатель массива будет непонятно куда смотреть.
Но мы же не ищем сложных путей? Решение в лоб — для каждого поста явно указываем идентификатор, т.к. функция выбора контента оперирует с глобальным массивом, то вообще никаких проблем, вместе со ссылкой на полный текст новости передаем идентификатор новости. И получаем что-то типа такого:
var request = require('request'),
	cheerio = require('cheerio'),
	res_arr = [],
	ind = 0;

var news_base_url = 'http://need.url?p=';

get_page_content(news_base_url + 0, 0);

function get_page_content( url, i ) {
	request(url, function ( error, response, body ) {

		if( !error ) {
			var $ = cheerio.load(body),
				newses = $('.news-item');

			newses.each(function () {
				var self = $(this),
					cont = self.find('.news-text');


				res_arr[ind] = {
					title: cont.find('.title').text(),
					date : cont.find('.date').text(),
					link : cont.find('a').attr('href'),
					img  : cont.find('img').attr('src')
				}

				get_post_content(link, ind);

				ind++;
			});

		} else {
			console.log("Произошла ошибка: " + error);
		}
	});
}

function get_post_content( link, array_index ) {
	request(link, function ( error, response, body ) {

		if( !error ) {
			var $ = cheerio.load(body, {decodeEntities: false});

			res_arr[array_index].content = $('.text').html();

		} else {
			console.log("Произошла ошибка: " + error);
		}
	});
}
Все это круто, но как нам получить данные? Не из консоли же копировать? Но опять же асинхронность в nodejs не позволяет нам просто взять и в последней итерации сохранить все на диск, т.к. последняя итерация еще ничего не значит, где-то может тупить страница и только забираться контент. И снова, ничего умнее счетчика я не придумал. Т.к. получение полного текста новости будет идти в конце, то проверку нужно делать там и проверять не по индексу новости, а завести отдельный счетчик, который будет вести учет реально полученный или не полученный данных. Для работы с файлами надо подключить модуль FileSystem (FS), а чтобы получить папку текущего скрипта, туда же мы будем складывать результаты парсинга, подключаем модуль Path.
Итоговый скрипт, выглядит примерно так:
var request = require('request'),
	cheerio = require('cheerio'),
	fs = require('fs'),
	path = require('path'),
	res_arr = [],
	ind = 0,
	count_posts = 500;

var news_base_url = 'http://need.url?p=';

	// Имя файла в той же папке, где лежит файл скрипта
var file_json = path.resolve(__dirname, 'parse_file.json');

get_page_content(news_base_url + 0, 0);

function get_page_content( url, i ) {
	request(url, function ( error, response, body ) {

		if( !error ) {
			var $ = cheerio.load(body),
				newses = $('.news-item');

			newses.each(function () {
				var self = $(this),
					cont = self.find('.news-text');


				res_arr[ind++] = {
					title: cont.find('.title').text(),
					date : cont.find('.date').text(),
					link : cont.find('a').attr('href'),
					img  : cont.find('img').attr('src')
				}

				get_post_content(link, ind);

				ind++;
			});

		} else {
			console.log("Произошла ошибка: " + error);
		}
	});
}

// Получение контента
function get_post_content( link, array_index ) {
	request(link, function ( error, response, body ) {

		if( !error ) {
			var $ = cheerio.load(body, {decodeEntities: false});

			res_arr[array_index].content = $('.text').html();

		} else {
			console.log("Произошла ошибка: " + error);
		}

		if( count_posts-- <= 0 ){
			write_parse_res( file_json, JSON.stringify(res_arr) );
		}
	});
}

// Сохранение на диск
function write_parse_res( file_json, str ) {
	fs.writeFile(file_json, str, function ( err ) {
		if( err ) {
			console.log(err);
		} else {
			console.log('Добавил все');
		}
	});
}
Понятно, что значение количества постов надо как-то «более технологично» получать, но в моем случае, этого было достаточно.
Задача решена. Процесс импорта новостей на новый сайт не буду рассматривать, это выходит далеко за рамки задачи, и может сильно отличатся в зависимости от CMS и структуры БД, сами уж как-нибудь разберетесь.
Клиент доволен как слон, все его новости на месте, а это главное. На самом деле, не главное =) Главное, что доволен я, все получилось очень даже неплохо. Мои скилы прокачаны, nodejs в очередной раз побежден!
Бот дразнилка для telegram
Однажды, в одной группе мессенджера телеграм появился занятный бот, который умел передразнивать фразы «да» и «нет». Если сообщение любого из участников заканчивалось на что-то похожее на «да/нет», он отвечал: «Пакет го*на» или «Го*на пакет» (не будем нецензурщиной осквернять блог). В общем. прикольно.
Я его добавил в офисную группу, и он периодически отвечал, но потом стал все реже проявлять активность, тупить, к тому же народ требовал хлеба и зрелищ, а именно возможности обучать бота, чтобы его лексикон стал расширяемым. Как итог, у меня появилась идея создания своего бота, который бы повторял функции существующего, но дополнительно мог обучаться.
На тот момент у Ильи (еще один наш разработчик) уже был опыт написания бота для promurom.ru, он его писал на php. «Php — это не интересно», — подумал я, к тому же давно было желание в изучении nodejs, а тут нескольких зайцев: и прокачка скилов, и развлечение, и новые технологии =) Про написание ботов есть стопицот постов и мануалов, я не буду подробно рассказывать все этапы регистрации и разработки (чего там разрабатывать? 3 строчки кода и 2 библиотеки для nodejs). Самая главная библиотека Telegram Bot API for NodeJS — это обертка над стандартным АПИ телеграма. Для меня очень сложным был процесс понимания как же боты работают, не саму обработку запросов, а именно процесс общения между сервером телеграм и моим сервером. Я себе представлял это так: пользователь шлет команду боту, сообщение уходит на сервер теоеграм, оттуда идет на мой сервер, забирает ответ и отправляет этот ответ в чат (забегая вперед скажу, что так он тоже может, но процесс настройки чуть сложнее). В действительности все оказалось проще, собственно сам бот крутить на сервере и с некоторой периодичностью присасывается к серверу телеграми и слушает не пришло ли ему чего (Long polling) Никаких сложных настроек сервера и протоколов.
За пару часов я накидал частичный аналог старого бота, который реагировал на да/не и еще пару фраз, запулил его на сервере и добавил в офисную группу.
Теперь переходим к следующему этапу, наделим бота способностью учиться. Как-то не сразу в моей голове сложилось понимание как реализовать весь процесс и в каком формате хранить данные. Сначала родилось решение «в лоб» завести базу из одной таблицы, состоящей из 2х полей, где будут храниться фразы и ответы а них. Но этот вариант с моими навыками на тот момент показался сложноватым. К тому же идея при каждом запросе дергать базу тоже не внушала оптимизма. В дело вступил коллективный разум, я закинул проблему в общий чат и обсуждение началось. Конечно, буквально за пару десятков фраз мы ушли то основной темы и стали рассуждать как можно еще «улучшить» бота, наделить его ИИ и т.д. Но одна хорошая мысль прозвучала: «Не бойся часто дергать файловую систему, это не так долго (тем более в век ssd), а самое главное — просто». В общем, принял решение, что хранить словарь буду в файле на диске. А потом мне пришло понимание, что я работаю с процессом, который не останавливается, nodejs запускается аки демон и висит в процессах, пока его не убьешь явно. Т.е. при запуске все переменные попадают в память и никуда оттуда не деваются, если, конечно, ты сам их не прибьешь, следовательно, словарь будет все время лежать в ОЗУ, а это самое быстрое что может быть. И так решение: словарь храним на диске, при запуске забираем его в память и работаем из ОЗУ, при расширении словаря пишем на диск обновленный словарь — ПРОФИТ!
С форматом хранения не стал долго ломать голову, есть стандартный для js — json (в честь Джейсона Стетема, наверное), вот его и взял за основу, фраза в качестве ключа, а ответ значение:
{
	"фраза 1": "ответ 1",
	"Фраза 2": "ответ 2"
}
Потом пришла мысль: «А если будет несколько ответов на одну фразу?». Несколько одинаковых ключей быть не может, поэтому, не мудрствуя лукаво — фраза в качестве ключа, а значения хранить в массиве. И в итоге получаем такую структуру:
{
	"фраза 1":[
		"ответ 1.1",
		"ответ 1.2"
	],
	"фраза 2":[
		"ответ 2.1",
		"ответ 2.2"
	]
}
При выборе ответа берем какую-нибудь функцию генерации случайного числа и на его основе выбираем элемент массива. С форматом хранения ок, а как же обучать?
Что я понял про команды бота для телеграм? Все фразы, которые начинаются со слеша имеют атрибут команда, для чего их регистрировать через папу-бота, мне так и не понятно, может, я что-то не так читал или это проблема обертки для nodejs, но факт остается фактом. Обработку команды /help также пишет сам разработчик, следовательно что он хочет, то и выводит, я думал, что хэлп на уровне сервера работает, и отдает все зарегистрированные команды. Т.е. если бот не приватный, то можно вообще любую фразу интерпретировать как команду. Я создал команду обучения:
/learn_new фраза=ответ
Если формат будет не правильный, бот об этом сообщит. Из недостатков: в качестве фразы может быть только одно слово, бот реагирует только на последнее слово.
Вот как-то так =) Ищите во всех телеграмах страны, бот с именем Draznilka.
